Muchas organizaciones ya tienen sensores en sus casetas de bombeo remotas, almacenes y sitios sin personal — y aun así descubren los problemas tarde. Las alarmas caen en un grupo de chat que no tiene dueño. El mismo evento llega cinco veces. Una falla de comunicación deja el último valor en el panel con un aspecto tranquilizadoramente actual durante tres días.
A escala de flota el problema cambia de forma: los datos eléctricos, de motores, de vibración y ambientales están en archivos separados, el equipo dedica su tiempo a reunir evidencia en lugar de comparar riesgos, y un activo ruidoso pero inofensivo le roba la atención a uno crítico y silencioso.
Esta guía cubre ambos casos: lograr que un sitio remoto produzca una respuesta confiable y priorizar el mantenimiento entre muchos sitios.
Parte 1: sitios remotos
La pregunta a responder
¿Un cambio relevante llegará a alguien que pueda actuar?
Diseñe la medición en torno a la decisión
Empiece por la decisión operativa y luego elija la medición — temperatura, humedad, presión, caudal, vibración o una entrada de estado. Después:
- valide el rango del sensor, la conversión a unidades de ingeniería y la tasa de actualización,
- defina normal, fuera de rango, ausente, desactualizado y desconectado como cinco condiciones separadas,
- pruebe el recorrido completo, desde un cambio controlado en el sensor hasta el teléfono de la persona responsable.
Qué contiene una alerta útil
- identificación del activo,
- hora,
- valor medido y el límite superado,
- cuánto tiempo lleva la condición,
- estado de calidad de los datos.
El silencio no es salud. Que un dispositivo se desconecte no prueba que el proceso físico se detuvo — y la ausencia de nuevas alarmas no prueba que el monitoreo funcione. Monitoree el monitoreo.
Responsables y escalamiento
Asigne a cada alarma un responsable, un plazo esperado de reconocimiento y una ruta de escalamiento adecuada al sitio. Use el canal de notificación que está habilitado y probado, en lugar de suponer que todo servicio de mensajería está disponible. Durante la puesta en marcha, simule escenarios aprobados de alarma y de pérdida de comunicación y confirme la recuperación. Registre los cambios operativos en el flujo de mantenimiento, no solo en el chat.
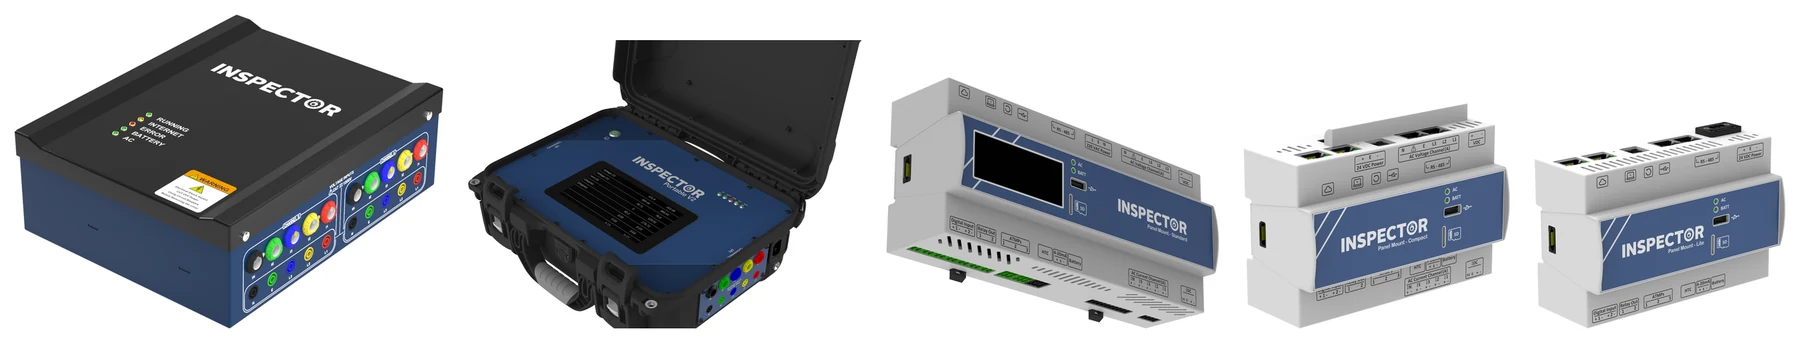
El Inspector Panel Mount Lite cubre puntos ambientales y de IoT de forma económica; un Inspector V4 o un Panel Mount Standard añaden calidad de energía donde importan los eventos eléctricos. Inspector alerta por SMS, correo y app, y guarda sus datos localmente en una tarjeta SD además de en la nube.
El monitoreo general no es un sistema de seguridad. El soporte de protocolos, canales, licencias y redes depende de cada implementación, y el monitoreo IoT no es un sistema certificado de incendio, gas, parada de emergencia ni otro sistema de seguridad de las personas.
Parte 2: flotas y operadores multisitio
La pregunta a responder
¿Qué activo necesita atención primero, y qué evidencia respalda esa decisión?
Construya una estructura común
- una jerarquía de sitios y activos coherente,
- unidades y definiciones de estado operativo coherentes,
- indicadores de calidad de datos en cada flujo,
- una decisión sobre qué registros brutos y resúmenes conservar para cada caso de uso,
- sincronización horaria, transferencia de datos y permisos confirmados para cada familia de dispositivos,
- un registro claro de qué analíticas están realmente habilitadas.
Clasifique el riesgo con honestidad
Compare cada activo con su propia línea base antes de clasificarlo frente a equipos distintos. Luego combine:
- cuánto ha cambiado la condición,
- cuánto tiempo ha persistido,
- qué tan crítico es el activo,
- cuánta confianza tiene en los datos.
Un índice de salud debe mostrar sus entradas y limitaciones, no ocultarlas. El monitoreo de condición por tendencias y reglas es útil — pero es distinto de un modelo validado que predice fallas o vida útil remanente.
Cierre el ciclo con mantenimiento
Cree una cola de revisión en la que cada elemento tenga:
- un resumen de la evidencia,
- un responsable,
- la próxima inspección,
- un criterio de cierre.
Transfiera la evidencia al sistema de mantenimiento existente mediante una integración soportada o un proceso manual controlado — Inspector Cloud exporta PDF para compartir, CSV para análisis y JSON para integración por API, y los equipos hablan Modbus, BACnet, DNP3, IEC 61850, MQTT y SNMP. Devuelva al historial del activo los hallazgos confirmados y las mediciones posteriores al mantenimiento. Ese retorno es lo que mejora la siguiente priorización.
Nombre solo lo que está validado. Las funciones de gemelo digital, IA, riesgo predictivo y vida remanente solo deben describirse dentro del alcance validado de la versión. Una conexión a la nube, por sí sola, no crea una predicción de fallas confiable — compare cualquier modelo predictivo con resultados definidos antes de confiar en él.
Escale solo cuando el piloto funcione
Amplíe a más sitios cuando el piloto produzca datos confiables, revisiones accionables y un proceso de cierre verificado. Más instrumentos no arreglan una pregunta operativa confusa ni una alarma sin dueño.
Qué medir para demostrar valor
- retardo entre sensor y notificación y tiempo de reconocimiento,
- cantidad de alarmas sin resolver y duración de datos desactualizados,
- desplazamientos innecesarios,
- condiciones de alta prioridad sin resolver,
- órdenes de trabajo respaldadas por evidencia y fallas repetidas,
- tiempo entre la observación y la acción.
El objetivo es una cobertura confiable y un ciclo de respuesta cerrado — no el mayor número posible de notificaciones.
Lecturas relacionadas
- Mantenimiento predictivo sin exageraciones
- Excursiones en farmacia y cadena de frío
- Lo que realmente le dice un analizador de calidad de energía
¿Muchos sitios y pocos ingenieros?
Un ingeniero le mostrará cómo se ve una flota en Inspector Cloud, con su lista de activos. Agendar reunión