Beaucoup d’organisations ont déjà des capteurs dans leurs stations de pompage isolées, leurs entrepôts et leurs sites sans personnel — et découvrent pourtant les problèmes trop tard. Les alarmes tombent dans un groupe de discussion que personne ne gère. Le même événement arrive cinq fois. Une panne de communication laisse la dernière valeur s’afficher pendant trois jours, rassurante et apparemment à jour.
À l’échelle d’un parc, le problème change de forme : données électriques, moteurs, vibrations et environnement sont éparpillées dans des fichiers séparés, l’équipe passe son temps à rassembler des preuves au lieu de comparer les risques, et un équipement bruyant mais inoffensif détourne l’attention d’un équipement critique qui reste silencieux.
Ce guide couvre les deux cas : obtenir une réponse fiable d’un site isolé, et prioriser la maintenance sur de nombreux sites.
Partie 1 : les sites isolés
La question à se poser
Un changement significatif parviendra-t-il à quelqu’un capable d’agir ?
Concevoir la mesure autour de la décision
Partez de la décision d’exploitation, puis choisissez la mesure — température, humidité, pression, débit, vibrations ou entrée d’état. Ensuite :
- validez la plage du capteur, la conversion en unités physiques et la fréquence de mise à jour,
- définissez normal, hors plage, manquant, figé et déconnecté comme cinq états distincts,
- testez toute la chaîne, d’une variation contrôlée du capteur jusqu’au téléphone de la personne responsable.
Ce que contient une alerte utile
- l’identification de l’équipement,
- l’heure,
- la valeur mesurée et la limite franchie,
- la durée de la condition,
- l’état de qualité des données.
Le silence n’est pas un signe de bonne santé. Un appareil hors ligne ne prouve pas que le process s’est arrêté — et l’absence de nouvelles alarmes ne prouve pas que la surveillance fonctionne. Surveillez la surveillance.
Responsabilité et escalade
Attribuez à chaque alarme un responsable, un délai d’acquittement attendu et une chaîne d’escalade adaptée au site. Utilisez le canal de notification activé et testé, au lieu de supposer que tous les services de messagerie sont disponibles. Pendant la mise en service, simulez des scénarios validés d’alarme et de perte de communication, et vérifiez le retour à la normale. Consignez les changements d’exploitation dans l’outil de maintenance, pas seulement dans la messagerie.
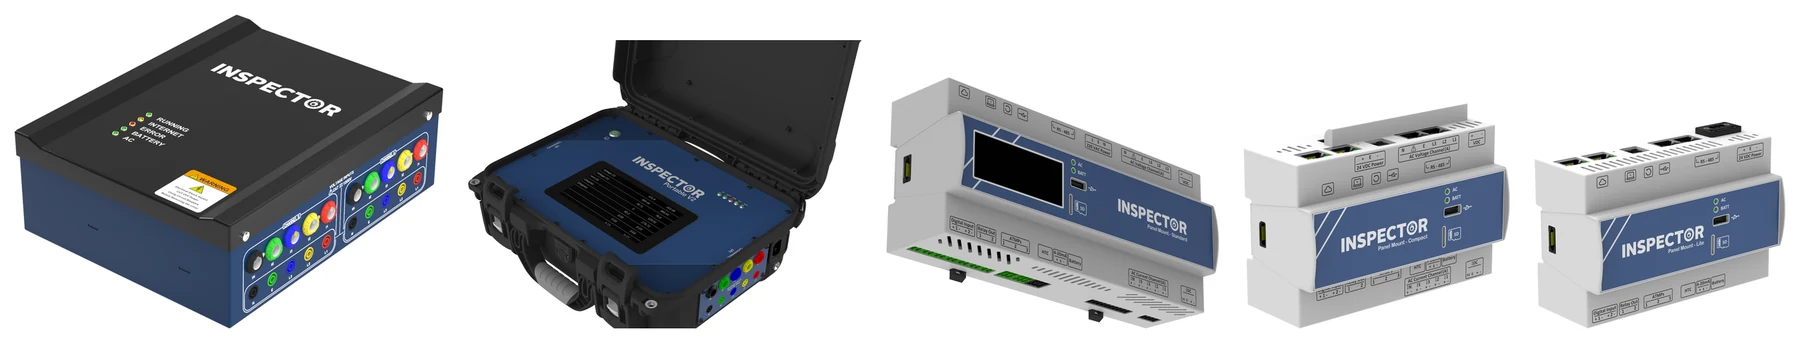
L’Inspector Panel Mount Lite couvre à moindre coût les points environnementaux et IoT ; un Inspector V4 ou un Panel Mount Standard ajoute la qualité de l’énergie là où les événements électriques comptent. Inspector envoie ses alertes par SMS, e-mail et application, et conserve ses données localement sur carte SD en plus du cloud.
La surveillance générale n’est pas un système de sécurité. La prise en charge des protocoles, canaux, licences et réseaux dépend de chaque déploiement, et la surveillance IoT n’est pas un système certifié de détection incendie, gaz, d’arrêt d’urgence ou de sécurité des personnes.
Partie 2 : parcs et exploitants multisites
La question à se poser
Quel équipement nécessite une attention en priorité, et quelle preuve étaye cette décision ?
Construire une structure commune
- une arborescence cohérente des sites et équipements,
- des unités et des définitions d’états de fonctionnement homogènes,
- des indicateurs de qualité des données sur chaque flux,
- une décision sur les données brutes et les synthèses à conserver pour chaque usage,
- une synchronisation horaire, une transmission et des droits d’accès confirmés pour chaque famille d’appareils,
- un relevé clair des analyses réellement activées.
Classer les risques honnêtement
Comparez chaque équipement à sa propre référence avant de le classer face à des équipements différents. Combinez ensuite :
- l’ampleur du changement,
- sa durée,
- la criticité de l’équipement,
- le niveau de confiance dans les données.
Un indice de santé doit montrer ses entrées et ses limites, pas les cacher. La surveillance d’état par tendances et règles est utile — mais elle diffère d’un modèle validé capable de prédire une panne ou la durée de vie résiduelle.
Boucler avec la maintenance
Créez une file de revue où chaque élément comporte :
- une synthèse des preuves,
- un responsable,
- la prochaine inspection,
- un critère de clôture.
Transférez les preuves vers la GMAO existante par une intégration supportée ou une procédure manuelle maîtrisée — Inspector Cloud exporte en PDF pour le partage, en CSV pour l’analyse et en JSON pour l’intégration par API, et les appareils parlent Modbus, BACnet, DNP3, IEC 61850, MQTT et SNMP. Réinjectez les constats confirmés et les mesures après intervention dans l’historique de l’équipement. C’est ce retour d’expérience qui améliore la priorisation suivante.
Ne nommez que ce qui est validé. Les fonctions de jumeau numérique, d’IA, de risque prédictif et de durée de vie résiduelle ne doivent être décrites que dans le périmètre validé de la version. Une connexion cloud ne crée pas à elle seule une prédiction fiable des pannes — comparez tout modèle prédictif à des résultats définis avant de vous y fier.
N’étendre qu’une fois le pilote concluant
Étendez à d’autres sites quand le pilote produit des données fiables, des revues exploitables et un processus de clôture vérifié. Plus d’instruments ne répareront pas une question d’exploitation floue ni une alarme sans responsable.
Ce qu’il faut mesurer pour démontrer la valeur
- le délai entre capteur et notification, et le temps d’acquittement,
- le nombre d’alarmes non résolues et la durée des données figées,
- les déplacements inutiles,
- les conditions prioritaires non résolues,
- les ordres de travail fondés sur des preuves et les pannes répétées,
- le délai entre l’observation et l’action.
L’objectif est une couverture fiable et une boucle de réponse fermée — pas le plus grand nombre possible de notifications.
À lire aussi
- La maintenance prédictive sans le battage
- Excursions en pharmacie et chaîne du froid
- Ce que dit vraiment un analyseur de qualité de l’énergie
Beaucoup de sites et peu d’ingénieurs ?
Un ingénieur vous montrera à quoi ressemble votre parc dans Inspector Cloud, à partir de votre liste d’équipements. Prendre rendez-vous