Muitas organizações já têm sensores em suas casas de bombas remotas, armazéns e instalações sem equipe — e ainda assim descobrem os problemas tarde. Os alarmes caem em um grupo de chat que não tem dono. O mesmo evento chega cinco vezes. Uma falha de comunicação deixa o último valor no painel parecendo tranquilamente atual por três dias.
Em escala de frota o problema muda de forma: dados elétricos, de motores, de vibração e ambientais ficam em arquivos separados, a equipe gasta o tempo juntando evidências em vez de comparar riscos, e um ativo barulhento mas inofensivo rouba a atenção de um ativo crítico e silencioso.
Este guia cobre os dois casos: fazer um único local remoto gerar uma resposta confiável e priorizar a manutenção entre muitos locais.
Parte 1: locais remotos
A pergunta a responder
Uma mudança relevante vai chegar a alguém que possa agir?
Projete a medição em torno da decisão
Comece pela decisão operacional e depois escolha a medição — temperatura, umidade, pressão, vazão, vibração ou uma entrada de estado. Em seguida:
- valide a faixa do sensor, a conversão para unidades de engenharia e a taxa de atualização,
- defina normal, fora da faixa, ausente, desatualizado e desconectado como cinco condições separadas,
- teste o caminho completo, de uma mudança controlada no sensor até o celular da pessoa responsável.
O que um alerta útil contém
- identificação do ativo,
- horário,
- valor medido e o limite ultrapassado,
- há quanto tempo a condição persiste,
- status de qualidade dos dados.
Silêncio não é saúde. Um dispositivo ficar offline não prova que o processo físico parou — e a ausência de novos alarmes não prova que o monitoramento está funcionando. Monitore o monitoramento.
Responsáveis e escalonamento
Atribua a cada alarme um responsável, um prazo esperado de reconhecimento e uma rota de escalonamento adequada ao local. Use o canal de notificação que está habilitado e testado, em vez de supor que todo serviço de mensagens está disponível. Durante o comissionamento, simule cenários aprovados de alarme e de perda de comunicação e confirme a recuperação. Registre mudanças operacionais no fluxo de manutenção, não apenas no chat.
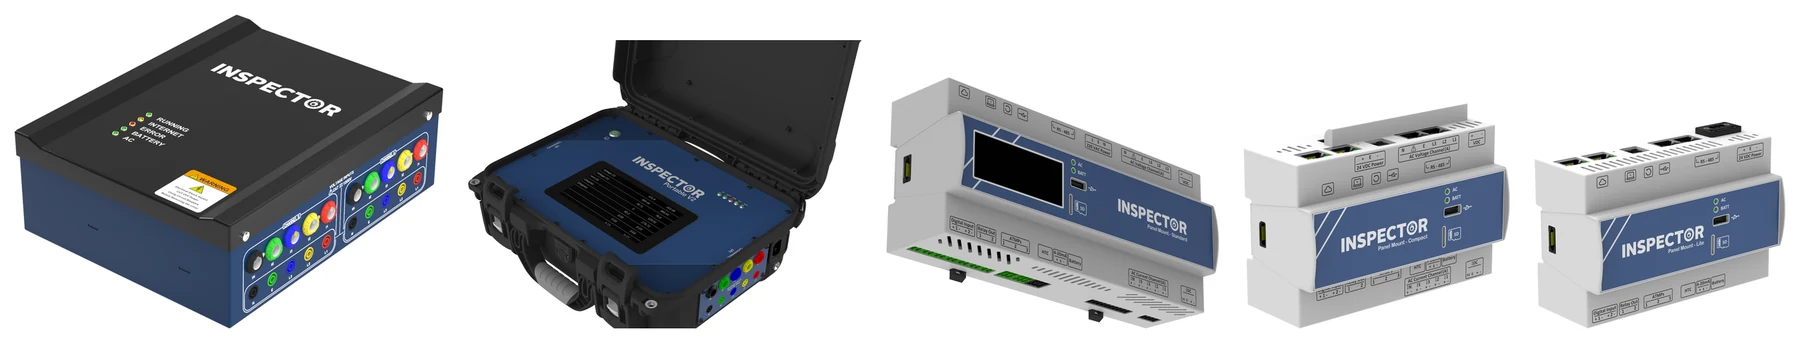
O Inspector Panel Mount Lite cobre pontos ambientais e de IoT de forma econômica; um Inspector V4 ou Panel Mount Standard acrescenta qualidade de energia onde eventos elétricos importam. O Inspector alerta por SMS, e-mail e aplicativo, e guarda os dados localmente em cartão SD além da nuvem.
Monitoramento geral não é um sistema de segurança. Suporte a protocolos, canais, licenças e redes depende de cada implantação, e o monitoramento IoT não é um sistema certificado de incêndio, gás, desligamento de emergência ou outro sistema de segurança da vida.
Parte 2: frotas e operadores multi-site
A pergunta a responder
Qual ativo precisa de atenção primeiro, e que evidência sustenta essa decisão?
Crie uma estrutura comum
- uma hierarquia de locais e ativos consistente,
- unidades e definições de estado operacional consistentes,
- indicadores de qualidade de dados em cada fluxo,
- uma decisão sobre quais registros brutos e resumos manter para cada caso de uso,
- sincronização de horário, transferência de dados e permissões confirmadas para cada família de dispositivos,
- um registro claro de quais análises estão de fato habilitadas.
Classifique o risco com honestidade
Compare cada ativo com a sua própria linha de base antes de classificá-lo contra equipamentos diferentes. Depois combine:
- o quanto a condição mudou,
- há quanto tempo ela persiste,
- o quão crítico é o ativo,
- o quanto você confia nos dados.
Um índice de saúde deve expor suas entradas e limitações, não escondê-las. Monitoramento de condição por tendências e regras é útil — mas é diferente de um modelo validado que prevê falha ou vida útil remanescente.
Feche o ciclo com a manutenção
Crie uma fila de revisão em que cada item tenha:
- um resumo das evidências,
- um responsável,
- a próxima inspeção,
- um critério de encerramento.
Transfira as evidências para o sistema de manutenção existente por uma integração suportada ou um processo manual controlado — o Inspector Cloud exporta PDF para compartilhar, CSV para análise e JSON para integração via API, e os dispositivos falam Modbus, BACnet, DNP3, IEC 61850, MQTT e SNMP. Devolva ao histórico do ativo os achados confirmados e as medições pós-manutenção. É esse retorno que torna a próxima priorização melhor.
Nomeie apenas o que está validado. Funções de gêmeo digital, IA, risco preditivo e vida remanescente só devem ser descritas dentro do escopo validado da versão. Uma conexão com a nuvem, sozinha, não cria previsão de falha confiável — compare qualquer modelo preditivo com resultados definidos antes de depender dele.
Escale só quando o piloto funcionar
Expanda para mais locais quando o piloto produzir dados confiáveis, revisões acionáveis e um processo de encerramento verificado. Mais instrumentos não consertam uma pergunta operacional confusa nem um alarme sem dono.
O que medir para mostrar valor
- atraso entre sensor e notificação e tempo de reconhecimento,
- quantidade de alarmes não resolvidos e duração de dados desatualizados,
- deslocamentos desnecessários,
- condições de alta prioridade não resolvidas,
- ordens de serviço baseadas em evidências e falhas repetidas,
- tempo entre a observação e a ação.
O objetivo é cobertura confiável e um ciclo de resposta fechado — não o maior número possível de notificações.
Leitura relacionada
- Manutenção preditiva sem exageros
- Excursões farmacêuticas e de cadeia fria
- O que um analisador de qualidade de energia realmente mostra
Muitos locais e poucos engenheiros?
Um engenheiro mostra como uma frota aparece no Inspector Cloud, usando a sua lista de ativos. Agendar reunião